

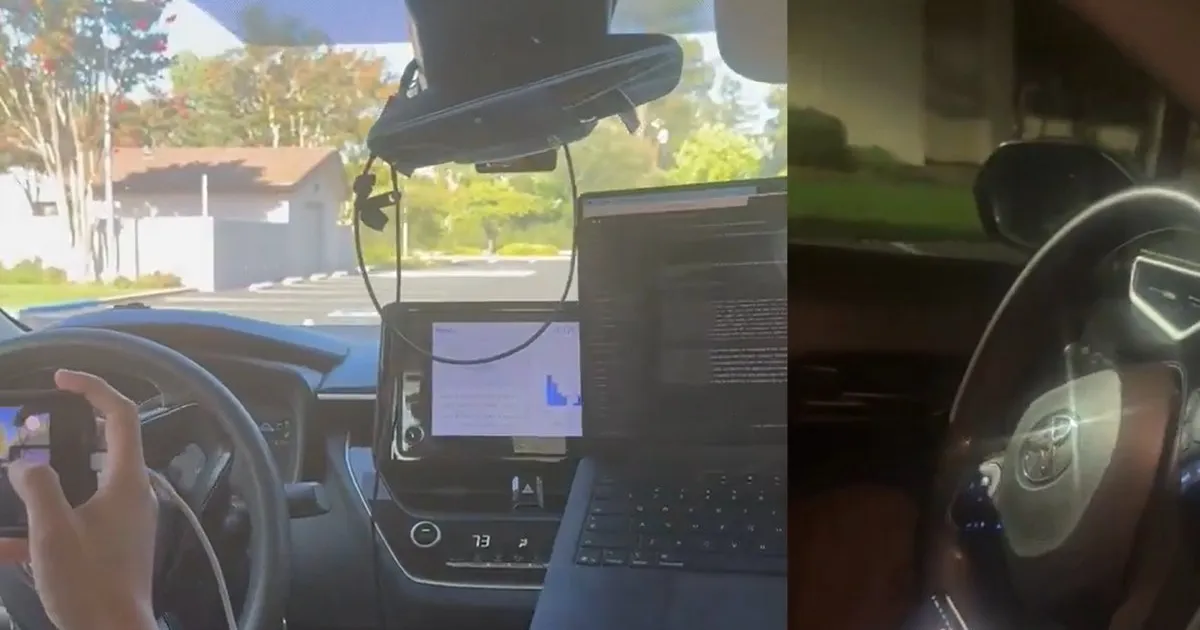
O echipă de cercetători a realizat un experiment pentru a evalua capacitatea agenților de inteligență artificială, precum ChatGPT sau Grok, de a conduce un vehicul. Testul, numit DrivingBench, a vizat verificarea modului în care modelele lingvistice mari (LLM) pot gestiona controlul fizic asupra unei mașini pe un traseu delimitat. Rezultatele obținute de cercetători arată că tehnologia actuală de tip agent AI este încă departe de a putea asigura o conducere sigură și precisă.
Experimentul a implicat utilizarea unui autoturism Toyota Corolla, dotat cu hardware-ul de viziune Comma și sistemul OpenPilot. Cercetătorii Aditya Ramabadran, Simon Mahns și Tobias Gessler au oferit modelelor Claude, ChatGPT și Grok controlul complet asupra direcției, accelerației și frânelor. Testul s-a desfășurat pe un traseu scurt într-o parcare, marcat cu conuri mici, iar agenții AI au primit instrucțiuni specifice de a comunica observațiile și acțiunile efectuate la fiecare pas.
Performanțele înregistrate au fost extrem de slabe, majoritatea agenților AI eșuând în încercarea de a parcurge traseul. Dintre cele 11 încercări efectuate cu patru agenți diferiți, opt au eșuat înainte de a parcurge doar 11% din distanță. Multe vehicule au ieșit din traseu chiar la prima curbă, realizând ceea ce echipa a descris drept un accident. Procesul de transmisie a comenzilor către centrele de date prin hotspot wireless a cauzat, de asemenea, opriri frecvente pe traseu.
Erorile specifice au evidențiat dificultățile de interpretare ale modelelor. Grok a interpretat greșit un spațiu dintre conuri ca fiind o poartă de trecere, ieșind din traseu după doar două comenzi. Un agent ChatGPT a inventat reguli false despre culoarea conurilor, contrazicând instrucțiunile primite. În general, agenții AI au demonstrat o incapacitate de a estima corect unghiul de virare necesar, rezultând în manevre insuficiente pentru parcurgerea curbelor prevăzute în test.
Singura excepție raportată în cadrul testului DrivingBench a fost modelul GPT-6 Astra. Acesta a reușit să finalizeze întregul traseu de test, însă abia la a doua încercare. Deși parcursul a fost unul neregulat, cu viraje foarte strânse și riscuri de ieșire din traseu chiar înainte de linia de sosire, acesta a fost singurul agent care a completat parcursul. Restul modelelor testate nu au reușit să depășească obstacolele de bază impuse de traseul de parcare.
Deși tehnologia de conducere autonomă utilizează deja inteligența artificială în diverse sisteme, acest test subliniază diferența dintre modelele lingvistice de tip chat și sistemele dedicate de navigație. Modelele LLM sunt antrenate pentru procesarea limbajului, nu pentru controlul mecanic precis, ceea ce explică dificultățile de estimare a spațiului și a mișcării în timp real necesare pentru siguranța rutieră.